Кратко: В одном B2B-проекте я видел типичную развилку: менеджер хотел выпускать релиз в пятницу, потому что функция уже была в коде, а тестовый прогон показывал риск потери данных при повторной отправке формы. Решение приняли не по ощущениям, а по двум артефактам: баг-репорту с шагами воспроизведения и релизному чек-листу, где этот сценарий стоял как блокирующий. В этом гайде разбираем, что такое тестирование ПО, какие виды существуют, как устроен процесс от анализа требований до релиза и почему тестирование — это не отдел по исправлению ошибок, а системная часть разработки.
Что такое тестирование программного обеспечения
Определение и цели тестирования
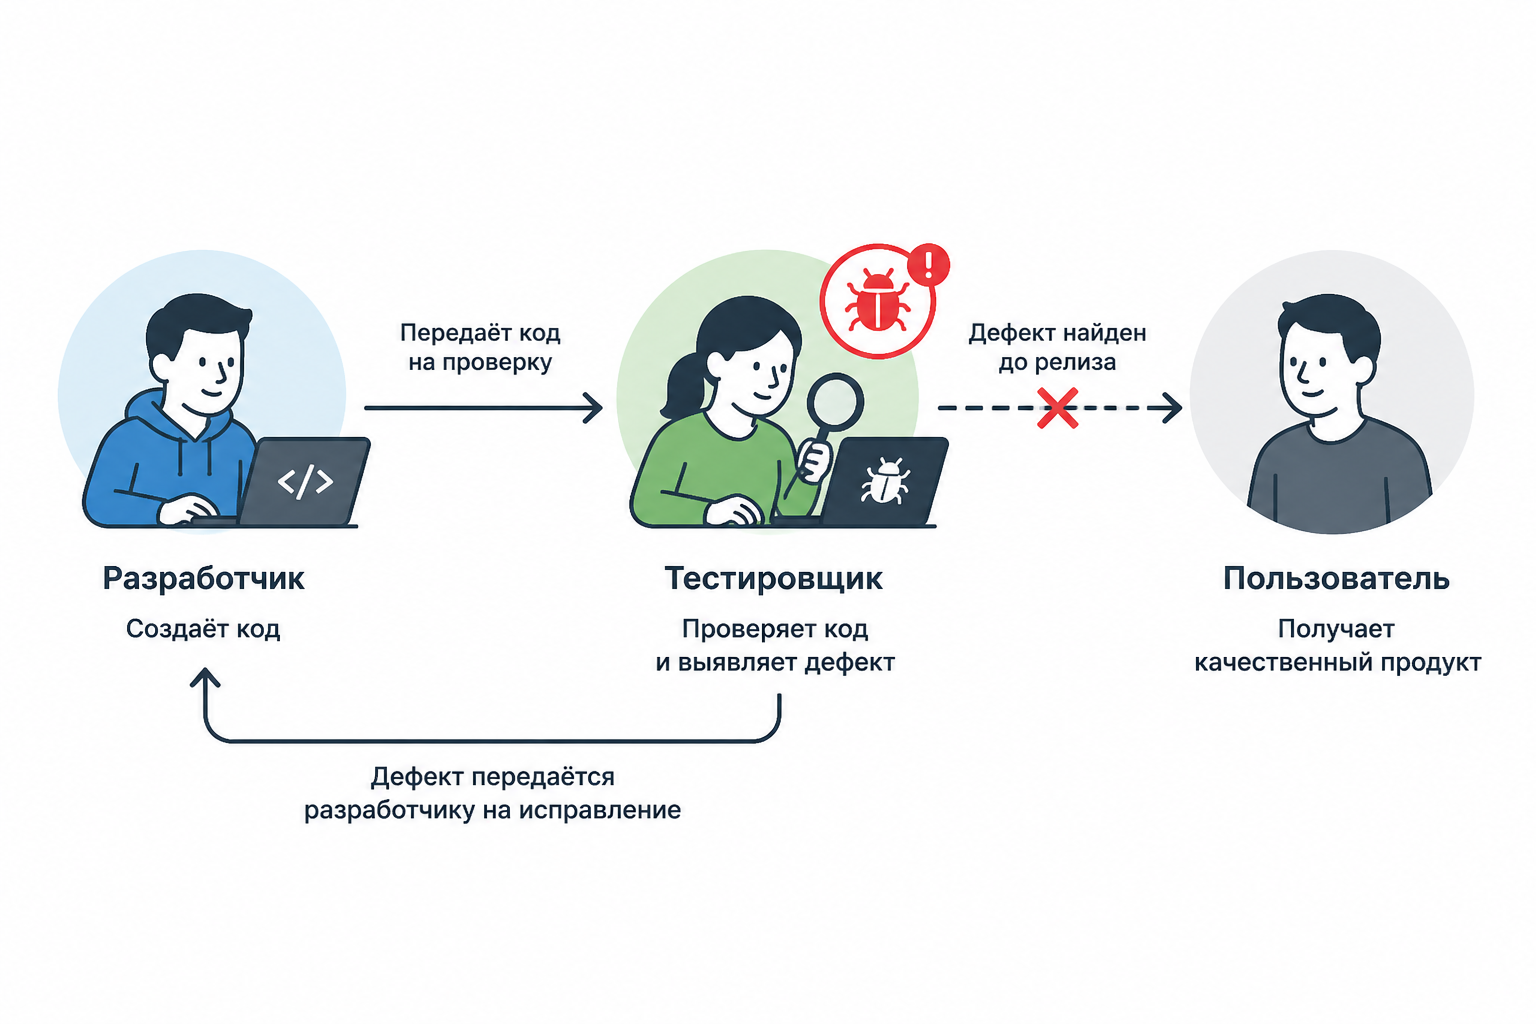
Тестирование программного обеспечения — это исследование продукта, при котором команда проверяет, где фактическое поведение системы расходится с требованиями, пользовательскими ожиданиями и бизнес-логикой.
Здесь важно сразу расставить акценты. Тестирование — не попытка сломать программу ради самого факта поломки. Это проверка соответствия между тем, что должно быть, и тем, что есть на самом деле. Расхождение между ожидаемым и фактическим результатом — и есть дефект, или баг.
Цели тестирования можно разделить на три уровня:
- Технические: найти баги раньше, чем они попадут к пользователю; проверить, что код выполняет заявленные функции; убедиться, что изменения не сломали то, что работало раньше.
- Процессные: получить данные о состоянии продукта для принятия решения о релизе; сформировать артефакты — тест-кейсы, баг-репорты, тест-план, — которые переиспользуются в следующих итерациях.
- Бизнесовые: снизить риск дорогих инцидентов после релиза, защитить репутацию продукта, обеспечить соответствие требованиям регуляторов, если это применимо.
Разница между первым и третьим уровнем принципиальна: тестировщик мыслит багами и кейсами, бизнес мыслит рисками и последствиями. Хорошее тестирование умеет говорить на обоих языках.
Зачем тестирование нужно бизнесу и заказчику

Классическое утверждение в индустрии звучит так: чем позже обнаруживается дефект, тем дороже его исправление. Важно понимать его не как универсальную формулу, а как практическое правило управления риском.
Пример из проекта с личным кабинетом для корпоративных клиентов. Перед релизом тестировщик проверял сценарий сохранения реквизитов и заметил, что при двойном клике по кнопке форма отправлялась дважды. В интерфейсе это выглядело как мелочь, но в базе появлялись дубли записей, а downstream-сервис забирал обе версии.
Два артефакта, которые помогли принять решение:
- Баг-репорт: шаги воспроизведения, ожидаемый результат — одна запись, фактический результат — две записи, severity — высокий, вложение с логом запроса.
- Релизный чек-лист: пункт Проверить повторную отправку критичных форм был отмечен как не пройден, поэтому релиз не соответствовал заранее согласованным критериям выпуска.
Без этих артефактов спор выглядел бы как субъективное мнение тестировщика против давления дедлайна. С ними команда увидела конкретный риск: выпускать можно, но с известной вероятностью загрязнить данные клиентов и потом чинить не только код, но и последствия в базе.
Что это значит практически для заказчика и менеджера проекта:
- Инвестиции в тестирование на ранних этапах — это не просто статья расходов, а способ увидеть риск до того, как он станет инцидентом.
- Продукт без тестирования не значит быстрее в продакшн — он может означать дороже поддерживать и чаще тушить пожары.
- Отчёты тестировщика — это управленческая информация: какие функции готовы, какие рискованны, можно ли выпускать релиз.
Для стартапов с ограниченными ресурсами тестирование часто воспринимается как задача на потом. На практике именно у небольших команд баги в продакшне бьют сильнее: нет ни большой поддержки, ни запаса доверия пользователей на ошибки.
Ключевые принципы тестирования ПО
За десятилетия практики индустрия сформулировала несколько принципов, которые работают независимо от методологии, стека и размера команды. Знание этих принципов помогает не делать типичных ошибок в организации тестирования.
Тестирование демонстрирует наличие дефектов, а не их отсутствие
Это один из самых важных и одновременно самых плохо усваиваемых принципов. Когда тесты проходят — это не доказательство того, что багов нет. Это доказательство того, что проверенные сценарии отработали корректно.
На практике это означает: нельзя говорить, что багов нет. Можно говорить: проверены такие-то сценарии, дефектов в них не обнаружено. Разница кажется формальной, но она меняет управленческие решения. Если тест-план покрывал только happy path, а негативные сценарии не проверялись — это риск, который нужно зафиксировать явно.
Именно поэтому грамотный тестировщик всегда указывает, что тестировалось и что — нет. Тест-план с явными границами покрытия честнее, чем общая фраза система протестирована.
Исчерпывающее тестирование невозможно
Для любого нетривиального приложения полное покрытие всех возможных входных данных, состояний и сценариев технически недостижимо. Число комбинаций растёт экспоненциально даже для небольших форм с несколькими полями.
Вывод, который из этого следует: тестирование — это управление рисками, а не попытка проверить всё. Задача тест-дизайна — выбрать сценарии с наибольшим потенциалом обнаружить критичные дефекты при ограниченных ресурсах.
Техники тест-дизайна — классы эквивалентности, граничные значения, попарное тестирование — существуют именно для того, чтобы максимизировать покрытие при конечном числе тест-кейсов.
Другие фундаментальные принципы
Раннее тестирование. Чем раньше тестирование подключается к процессу, идеально — с этапа требований, тем дешевле находимые дефекты. Концепция Shift Left Testing — сдвиг тестирования влево по временной шкале разработки — выросла именно из этого принципа.
Скопление дефектов (Defect Clustering). На практике значительная часть дефектов концентрируется в небольшом числе модулей. Если в одном компоненте уже найдено несколько багов — это сигнал, что там стоит искать ещё. Опытный тестировщик распределяет усилия с учётом этого паттерна, а не тратит равное время на каждый модуль.
Парадокс пестицида. Если раз за разом прогонять одни и те же тесты, их эффективность снижается: система привыкает к ним, и новые дефекты они не выловят. Тест-кейсы нужно регулярно пересматривать и добавлять новые.
Тестирование зависит от контекста. Подходы к тестированию банковского приложения, мобильной игры и медицинского устройства принципиально различаются. Нет универсального правильного процесса — есть процесс, адекватный контексту.
Заблуждение об отсутствии ошибок. Система может проходить все тесты и при этом не решать задачу пользователя. Работает без багов и решает бизнес-задачу — разные утверждения. Это граница между тестированием (QC) и обеспечением качества (QA) — подробнее разберём в отдельном разделе.
Виды тестирования программного обеспечения

Классификаций тестирования существует несколько, и они не взаимоисключающие. Один и тот же тест может быть одновременно функциональным, ручным и регрессионным. Разберём основные категории с акцентом на то, когда и зачем их применяют.
Функциональное тестирование
Функциональное тестирование проверяет, что система делает то, что должна делать согласно требованиям. Это самая прямолинейная категория: есть функция — проверяем, работает ли она.
Внутри функционального тестирования выделяют несколько уровней, и их иерархия важна:
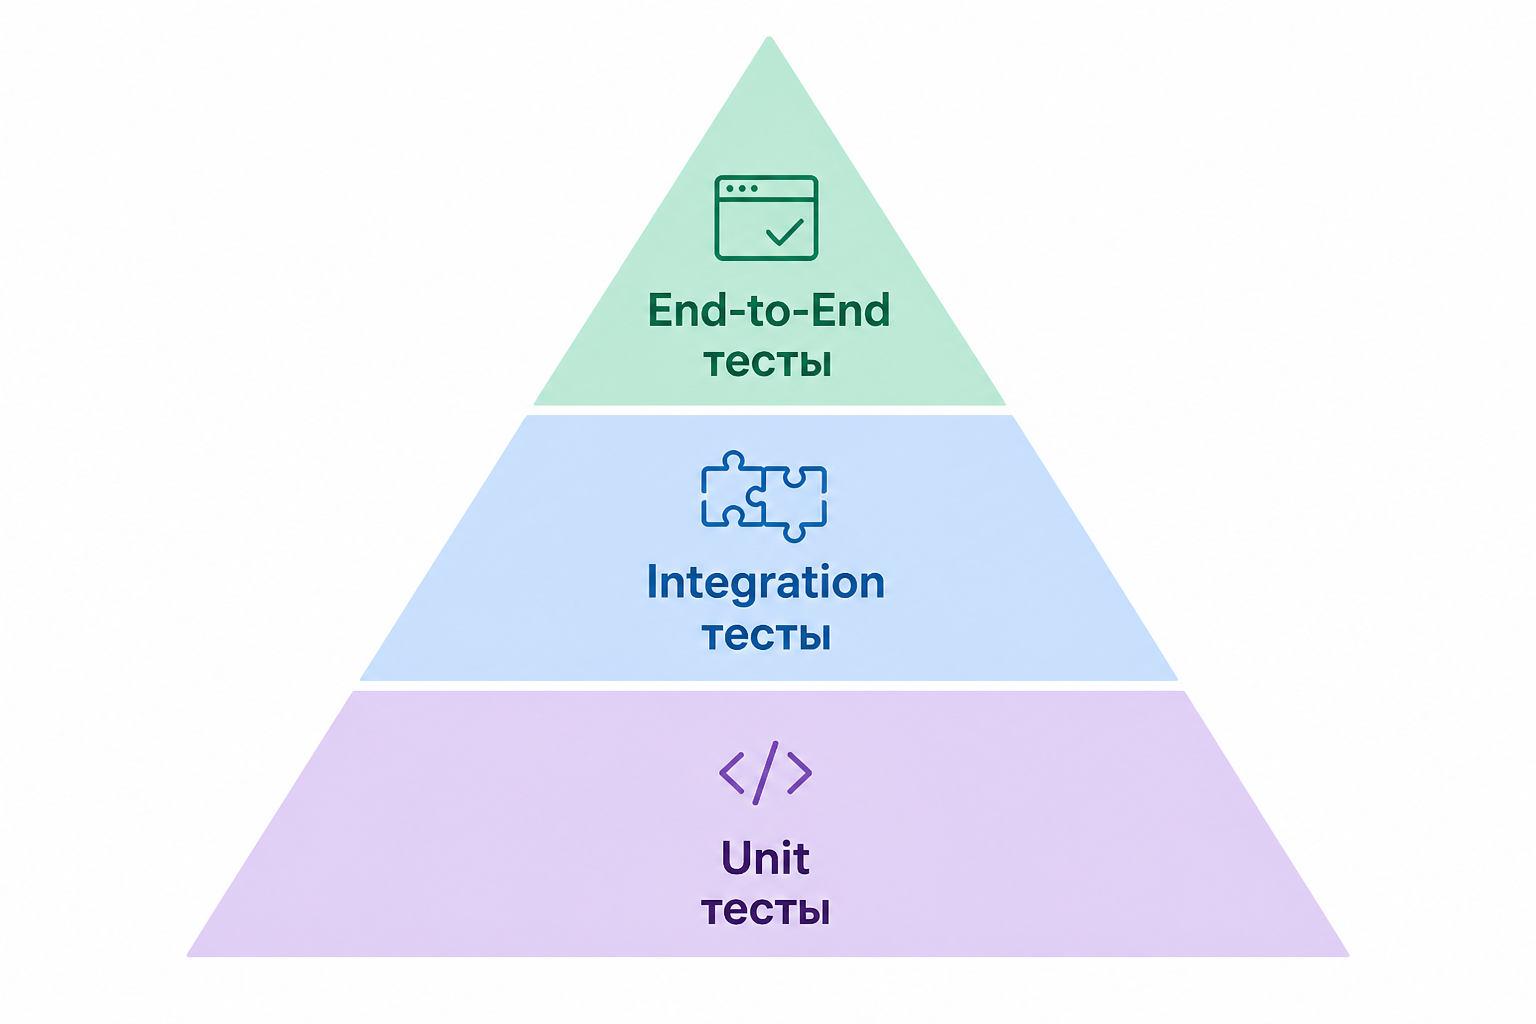
Модульное (unit) тестирование — проверка отдельных компонентов кода: функций, методов, классов — в изоляции от остальной системы. Обычно пишется и выполняется разработчиками. Unit-тесты быстрые, их много, они образуют основание пирамиды тестирования. Пример: проверка функции расчёта скидки с разными входными параметрами.
Интеграционное тестирование — проверка взаимодействия между модулями или сервисами. Компоненты по отдельности работают — а вместе? Типичный сценарий: API-сервис корректно передаёт данные в базу данных, а база возвращает правильный ответ. Интеграционные тесты выявляют ошибки на стыках компонентов, которые unit-тесты не видят.
Системное тестирование — проверка всей системы как единого целого. Тестируется полный сквозной сценарий: пользователь регистрируется, входит в приложение, совершает действие и получает ожидаемый результат. На этом уровне проверяются функциональные требования к продукту в целом.
Приёмочное тестирование (UAT — User Acceptance Testing) — финальная проверка перед релизом, которую проводит заказчик или представители целевой аудитории. Цель — убедиться, что продукт решает реальную бизнес-задачу, а не только проходит технические тесты. UAT часто обнаруживает расхождения между тем, что разработала команда, и тем, что имел в виду заказчик.
Нефункциональное тестирование
Нефункциональное тестирование проверяет не что делает система, а как она это делает: насколько быстро, безопасно и удобно.
Нагрузочное тестирование (Performance / Load Testing) — проверка поведения системы под нагрузкой. Как ведёт себя сервис, когда к нему одновременно обращаются тысячи пользователей? Выдержит ли база данных пиковый трафик в период акций? Нагрузочное тестирование критично для e-commerce, финтеха, любых систем с непредсказуемыми пиками нагрузки. Инструменты: JMeter, Gatling, k6.
Тестирование безопасности (Security Testing) — проверка защищённости системы от несанкционированного доступа, инъекций, утечек данных. Включает как анализ кода (SAST), так и попытки эксплуатации уязвимостей (Penetration Testing). Для продуктов, работающих с персональными данными или финансами, это не опциональная проверка, а требование.
Тестирование удобства (Usability Testing) — проверка того, насколько интерфейс понятен реальным пользователям. Проводится с привлечением людей из целевой аудитории; тестировщик наблюдает, как они выполняют задачи, и фиксирует точки затруднения. Это граница между техническим тестированием и UX-исследованием.
Тестирование совместимости (Compatibility Testing) — проверка корректной работы в разных окружениях: браузерах, операционных системах, устройствах, версиях API. Особенно актуально для веб-приложений и мобильных продуктов с широкой аудиторией.
Дымовое и регрессионное тестирование
Дымовое тестирование (Smoke Testing) — быстрая проверка самых критичных функций системы после каждой новой сборки. Цель: убедиться, что сборка жива и базовые сценарии работают, прежде чем запускать полный тестовый прогон. Название отсылает к практике электронщиков: новую плату включают и смотрят, не пойдёт ли дым. В разработке ПО smoke-тест — это первый фильтр, который экономит время команды.
Типичный состав smoke-теста: пользователь может войти в систему, главная страница загружается, ключевая бизнес-функция выполняется. Если smoke не прошёл — сборку возвращают разработчику без дальнейшего тестирования.
Регрессионное тестирование — проверка того, что новые изменения не сломали то, что работало раньше. Это одна из самых ресурсоёмких частей тестирования: с каждым релизом объём регрессии растёт, потому что накапливаются функции, которые нужно перепроверять. Именно регрессия — главный драйвер автоматизации тестирования: автотесты прогоняют регрессию быстрее и стабильнее, чем ручная проверка.
Ручное и автоматизированное тестирование: сравнение
Ручное тестирование выполняет человек: открывает приложение, воспроизводит сценарии, фиксирует результат. Автоматизированное — скрипты, которые делают то же самое без участия человека, быстрее и воспроизводимо.
Ни один подход не является универсально лучшим. Выбор зависит от типа теста, стадии проекта, бюджета и стабильности требований.
| Параметр | Ручное тестирование | Автоматизированное тестирование |
|---|---|---|
| Скорость выполнения | Медленнее, зависит от тестировщика | Быстрее после написания скриптов |
| Начальные затраты | Низкие | Высокие: разработка автотестов |
| Стоимость при масштабировании | Растёт вместе с объёмом проверок | Растёт медленнее, если скрипты поддерживаются и переиспользуются |
| Применимость | Исследовательское тестирование, UX, сложные сценарии, первичная проверка | Регрессия, нагрузочные тесты, повторяющиеся сценарии |
| Обнаружение неожиданных багов | Высокая — человек замечает аномалии вне сценария | Низкая — тест проверяет только то, для чего написан |
| Требования к навыкам | Знание предметной области, тест-дизайн | Знание языка программирования, фреймворков |
| Стабильность результата | Зависит от внимательности тестировщика | Воспроизводимый результат при неизменном коде и окружении |
| Ограничения | Сложно масштабировать, есть человеческий фактор | Высокие затраты на создание и поддержку |
Практический вывод: автоматизация не заменяет ручное тестирование — она освобождает тестировщика от рутины, чтобы он мог сосредоточиться на исследовательских и нестандартных сценариях, которые скрипт не увидит.
Этапы процесса тестирования: от постановки задачи до релиза
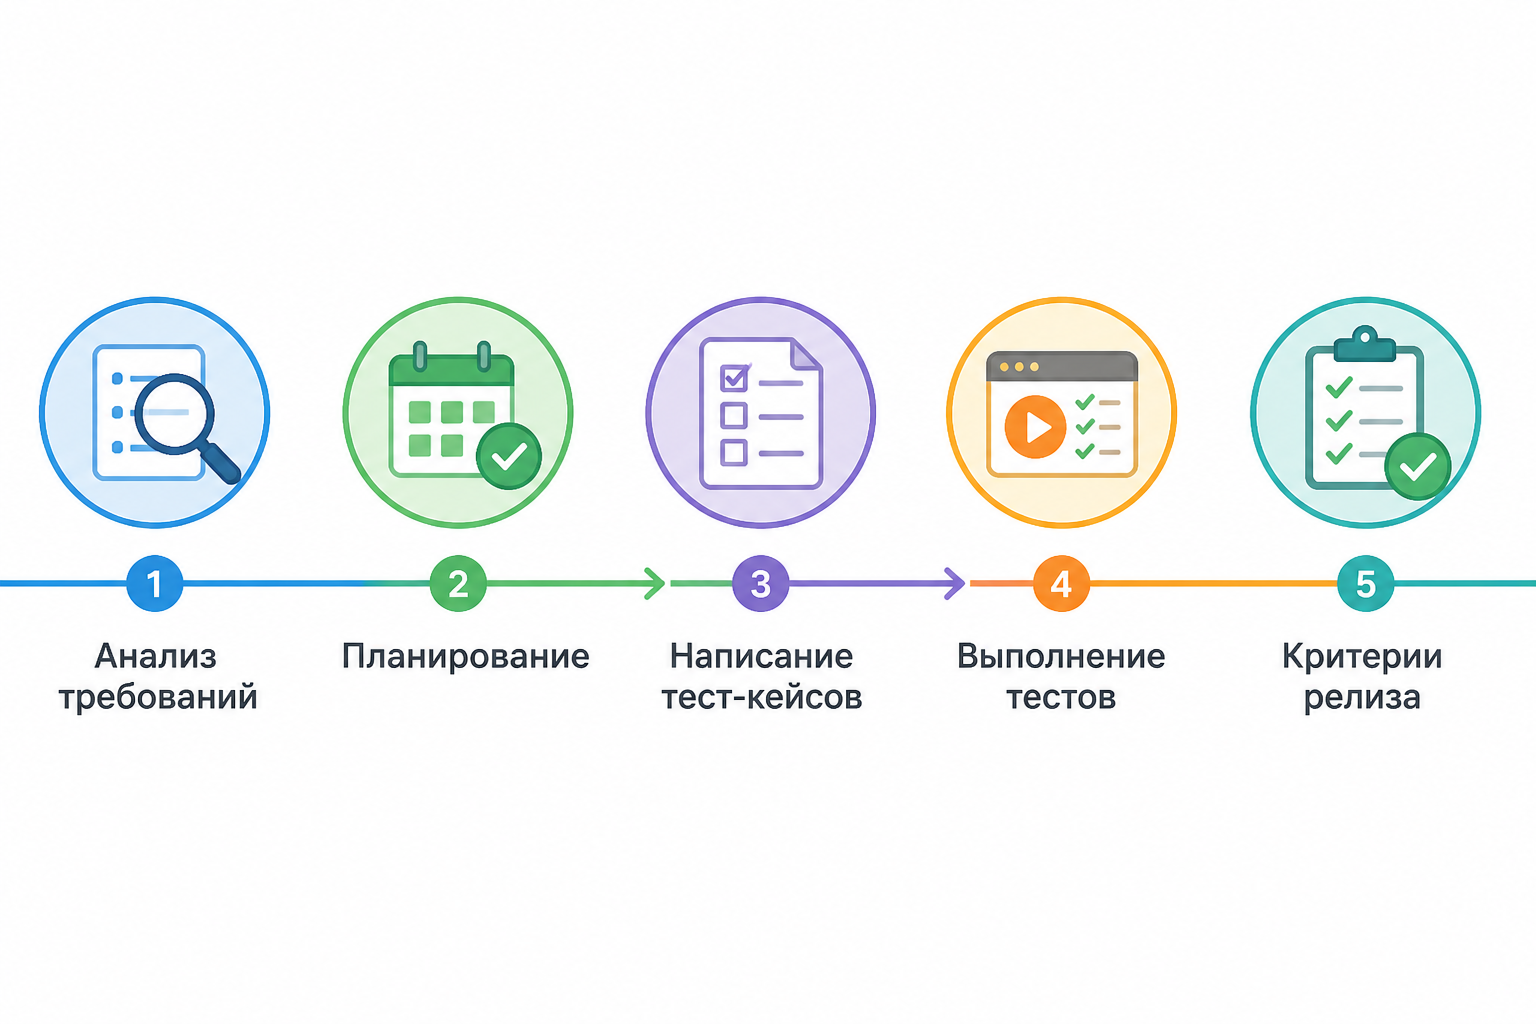
Процесс тестирования редко начинается с открытия приложения и поиска того, что сломалось. В зрелой команде это структурированный цикл с артефактами на каждом этапе. Разберём его пошагово.
Шаг 1 — Анализ требований и выявление ожиданий
До того как писать первый тест-кейс, тестировщик должен понять: что именно должна делать система и как определить, что она это делает правильно.
На этом этапе изучают:
- функциональные требования — что система делает;
- нефункциональные требования — как быстро, насколько безопасно, на каких устройствах;
- пользовательские истории и критерии приёмки;
- предыдущие баг-репорты и известные проблемные зоны.
Типичная ошибка — пропустить этот этап и начать тестировать по ощущениям. Результат: тесты проверяют то, что тестировщик предположил, а не то, что заказчик имел в виду. Расхождение выясняется на приёмочном тестировании — дорого и поздно.
Хороший практический приём на этом этапе — составить список вопросов к требованиям. Если в спецификации написано, что форма должна валидировать email, но не указано, что именно считается корректным форматом, это пробел, который нужно закрыть до написания тест-кейсов.
Шаг 2 — Планирование и приоритизация: шаблон бага и регламент
На этапе планирования команда отвечает на вопросы: что тестируем, в каком порядке, какими ресурсами, по каким критериям считаем тестирование завершённым.
Артефакт этого этапа — тест-план. Он может быть лёгким, например несколько абзацев в Confluence, или детальным — отдельный документ с разделами. В минимальном варианте тест-план содержит:
- цели тестирования;
- область покрытия и исключения;
- типы тестирования и подходы;
- критерии начала и окончания тестирования;
- роли и ответственность;
- инструменты и окружение.
Параллельно договариваются о регламентах: как оформляется баг-репорт, какие поля обязательны, каковы severity и priority у дефектов, кто принимает решение о блокировании релиза.
Шаблон баг-репорта (минимальный):
``` Заголовок: [Краткое описание, что сломано и где] Окружение: [версия ПО, ОС, браузер] Шаги воспроизведения:
- ...
- ...
- ...
Ожидаемый результат: [что должно произойти] Фактический результат: [что произошло на самом деле] Severity: [критический / высокий / средний / низкий] Вложения: [скриншот, лог] ```
Пустой баг-репорт без шагов воспроизведения — один из главных источников конфликтов между тестировщиками и разработчиками. Разработчик не может починить то, что не может воспроизвести.
Шаг 3 — Написание тест-кейсов и чек-листов
Тест-кейс — это детальное описание одного проверочного сценария: предусловия, шаги, ожидаемый результат. Тест-кейсы используются, когда важно точное и воспроизводимое выполнение, особенно для критичных функций или регрессии.
Чек-лист — более лёгкий формат: список пунктов проверить X, без детальных шагов. Быстрее писать, быстрее выполнять, но результат зависит от квалификации тестировщика. Чек-листы хороши для разведочного тестирования и несложных проверок.
Хороший тест-кейс имеет:
- однозначный ожидаемый результат, например страница загружается с сообщением Успешно сохранено, а не всё работает;
- конкретные предусловия: какие данные должны быть в системе, какой пользователь залогинен;
- атомарность — один тест-кейс проверяет одну вещь.
При написании тест-кейсов стоит покрывать не только позитивные сценарии, но и негативные: что происходит, если ввести невалидные данные? Если нажать кнопку дважды? Если сессия истекла в середине операции?
Шаг 4 — Выполнение тестов и управление дефектами
На этом этапе тест-кейсы выполняются, результаты фиксируются, обнаруженные дефекты заводятся в систему отслеживания: Jira, YouTrack, Linear и другие.

Управление дефектами — это не просто завели баг и ждём, пока починят. Это цикл:
- Баг обнаружен и оформлен тестировщиком.
- Баг назначен разработчику или приоритизирован на планировании.
- Разработчик исправляет и меняет статус на Исправлен.
- Тестировщик проводит верификацию — проверяет, что баг действительно исправлен и исправление не привнесло новых проблем.
- Баг закрывается или возвращается в работу.
Два ключевых понятия при управлении дефектами:
- Severity — насколько сильно баг влияет на систему технически. Критический severity — система упала или потеряла данные. Низкий — опечатка в подсказке.
- Priority — как срочно баг нужно исправить с точки зрения бизнеса. Баг может иметь низкий severity, но высокий priority: например, опечатка в названии компании на главной странице не ломает функциональность, но неприемлема перед конференцией.
Путаница между severity и priority — частая ошибка у начинающих тестировщиков.
Шаг 5 — Критерии выпуска релиза в продакшн
Как решить, что продукт готов к выпуску? Без явных критериев это превращается в субъективную дискуссию кажется, достаточно хорошо. Зрелая команда определяет критерии выхода (Exit Criteria) заранее.
Типичные критерии:
- все тест-кейсы с высоким приоритетом выполнены;
- критические и высокие баги закрыты или приняты к следующему спринту с явным обоснованием;
- smoke-тесты проходят стабильно;
- регрессия выполнена и не выявила новых критичных дефектов;
- UAT пройден и подписан заказчиком.
Важный момент: решение о выпуске принимает не тестировщик. Тестировщик предоставляет данные о качестве — метрики, количество открытых багов по severity, покрытие тест-кейсами. На основе этих данных менеджер и бизнес принимают взвешенное решение: выпускать, отложить или выпускать с известными ограничениями.
Тестировщик может и должен рекомендовать не выпускать релиз, если данные указывают на неприемлемый риск. Но финальное слово — за бизнесом.
Тестирование и качество продукта: в чём разница между QA и QC
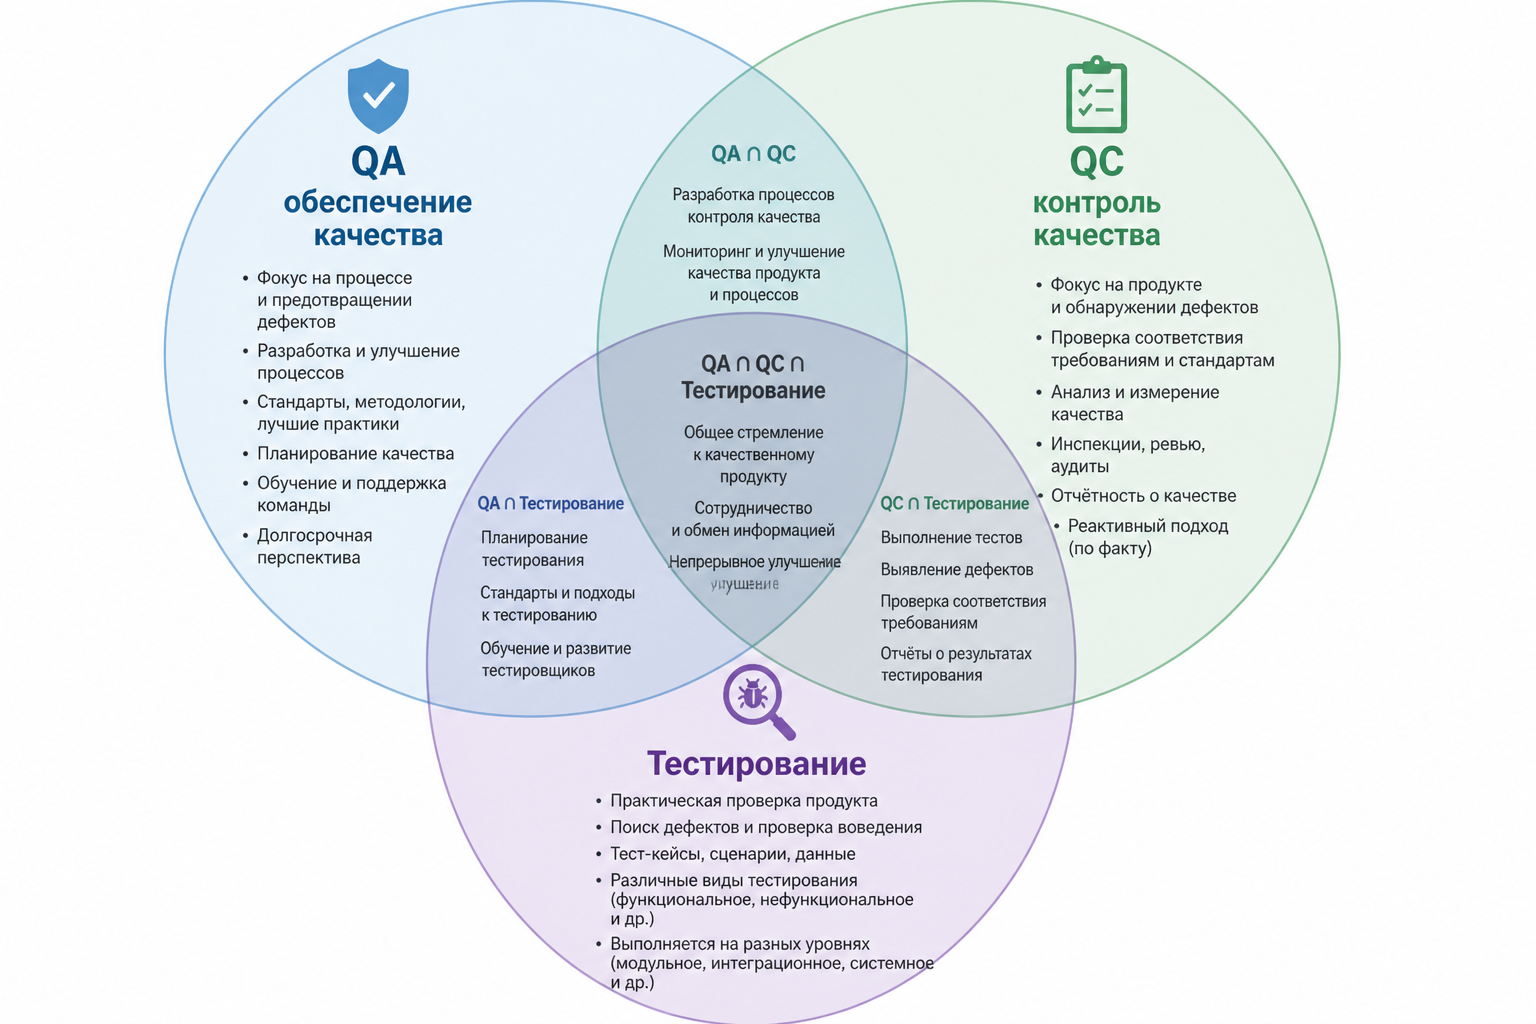
Отличия тестирования (QC) от обеспечения качества (QA)
В русскоязычной индустрии тестировщик, QA-инженер и специалист по качеству нередко используются как синонимы. На практике за ними стоят разные роли и разный уровень ответственности.
QC (Quality Control — контроль качества) — это деятельность по выявлению дефектов в уже созданном продукте. Тестирование — часть QC. QC реактивно: продукт создан, мы проверяем, насколько он соответствует требованиям.
QA (Quality Assurance — обеспечение качества) — это более широкая проактивная деятельность по созданию условий, при которых дефектов возникает меньше. QA влияет на процессы: как пишутся требования, как выстроен code review, насколько понятны стандарты разработки, как организовано взаимодействие команды. QA предотвращает дефекты, а не просто находит их.
Проще говоря: QC спрашивает, что сломалось, QA спрашивает, почему это вообще сломалось и как не допустить этого снова.
На практике во многих компаниях один специалист совмещает обе роли — выполняет тестирование и участвует в улучшении процессов. Но важно понимать разницу, чтобы не ограничивать работу только поиском багов.
Что тестировщик может сделать для улучшения качества
Даже в роли QC-специалиста тестировщик влияет на качество продукта шире, чем просто нашёл баг — завёл тикет.
Участие в ревью требований. Тестировщик, который читает user stories на этапе их написания, задаёт вопросы а что если и фиксирует неоднозначности, предотвращает дефекты ещё до первой строчки кода. Это называется Shift Left Testing.
Анализ паттернов дефектов. Если в одном модуле регулярно появляются схожие баги — это сигнал о системной проблеме: в коде, в процессе code review или в требованиях. Тестировщик, который замечает такие паттерны и сообщает о них, создаёт ценность за пределами отдельных тикетов.
Улучшение тест-культуры. Совместные сессии тест-планирования с разработчиками (Three Amigos: разработчик, тестировщик, аналитик), совместное написание acceptance criteria — всё это снижает количество недопонимания и повышает качество продукта до начала кодирования.
Метрики качества. Регулярная отчётность: сколько багов найдено на каком этапе, каков процент дефектов, ускользнувших в продакшн, какие функции исторически нестабильны. Эти данные помогают менеджменту принимать осознанные решения.
Влияние процесса тестирования на жизненный цикл ПО
Жизненный цикл программного обеспечения (SDLC — Software Development Life Cycle) включает несколько фаз: анализ и требования, дизайн, разработка, тестирование, деплой, сопровождение. Тестирование в этой модели традиционно ставится после разработки — и это источник проблем.
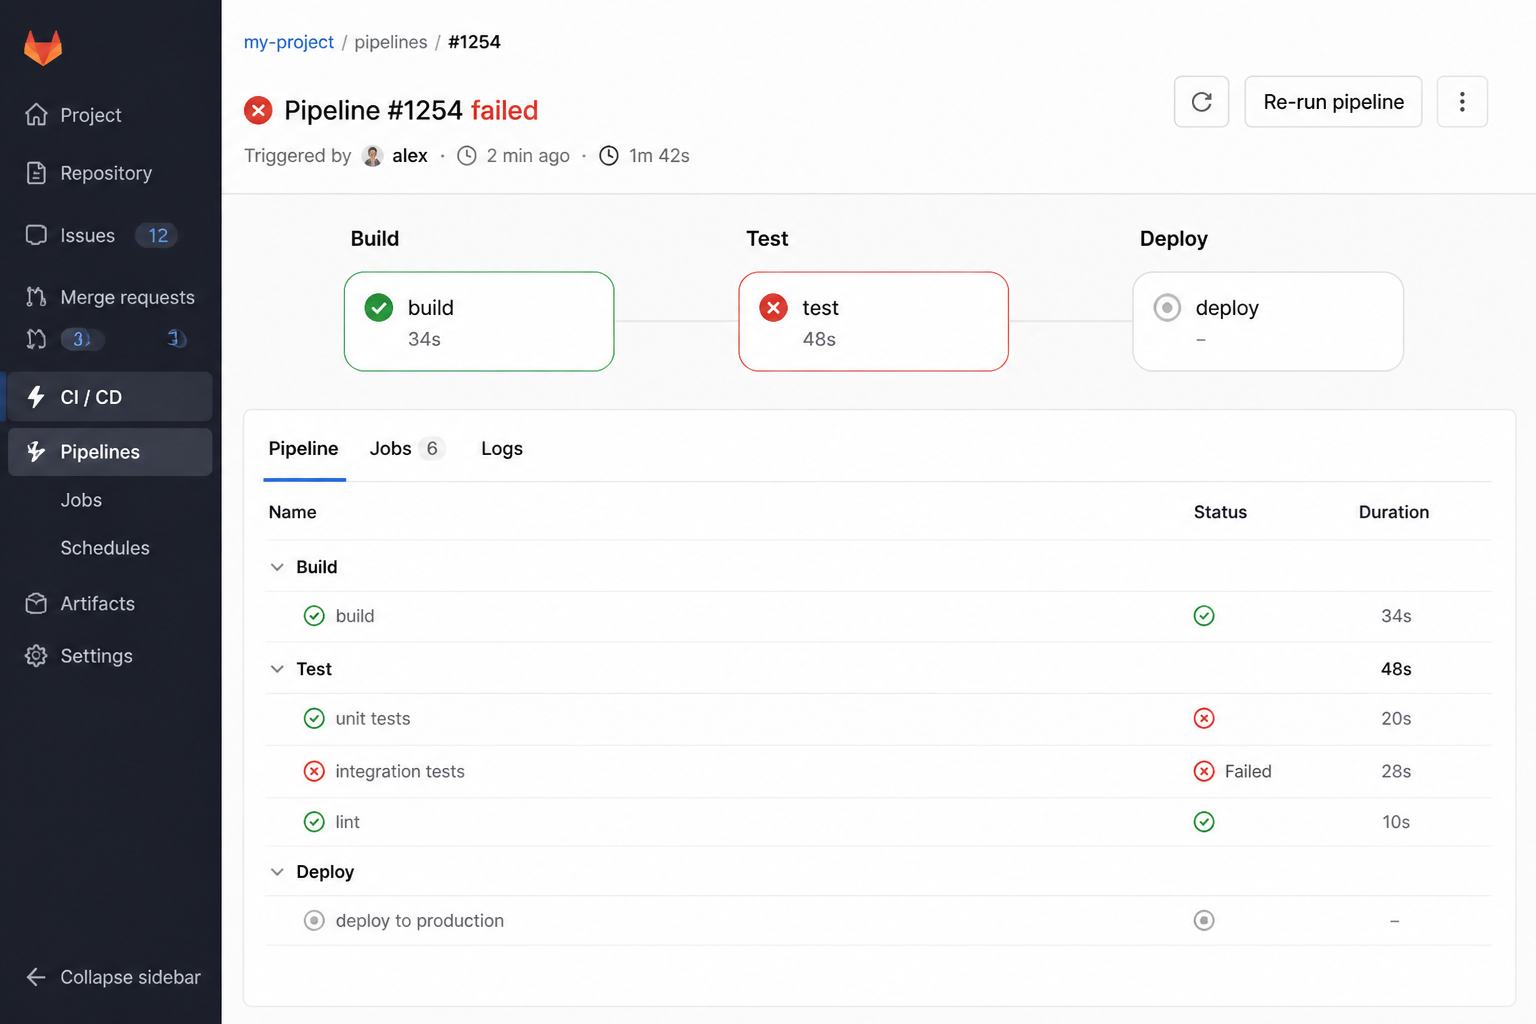
В современных методологиях Agile и DevOps тестирование интегрировано в каждую итерацию. Тестировщик работает параллельно с разработчиком, а не ждёт финального билда. CI/CD-пайплайны автоматически запускают тесты при каждом коммите — это означает, что обратная связь о качестве поступает через минуты, а не через дни.
Такой подход меняет роль тестировщика: из конечного фильтра перед релизом — в постоянного участника процесса, который влияет на качество на каждом шаге.
Как начать выстраивать тестирование в проекте: практические советы

Внедряйте изменения постепенно
Если в проекте раньше не было структурированного тестирования, попытка ввести всё сразу — тест-план, тест-кейсы, баг-трекер, автотесты и регламенты — почти всегда перегружает команду. Изменения не приживаются, и через месяц всё возвращается к ручной проверке перед релизом.
Разумная последовательность для небольшой команды:
- Начните с баг-трекера и единого формата баг-репортов. Это минимальный артефакт, который сразу даёт ценность: баги перестают теряться и становятся видимыми.
- Введите smoke-тест перед каждым тестовым прогоном. Простой чек-лист из 5–10 пунктов экономит время, если сборка нестабильна.
- Добавьте чек-листы для ключевых функций. Пусть они будут грубыми — лучше грубый чек-лист, чем тестирование по памяти.
- Переходите к тест-кейсам для критичных и часто ломающихся сценариев.
- Вводите регрессионный прогон перед каждым релизом.
Каждый шаг должен давать очевидную ценность команде — тогда изменения принимаются.
Когда подключать автоматизацию и как переиспользовать автотесты
Автоматизация не нужна на старте проекта с нестабильными требованиями. Если функции меняются каждую неделю, автотесты будут устаревать быстрее, чем их успевают писать. Результат — дорогостоящий технический долг.
Сигналы, что пора автоматизировать:
- Регрессионный прогон занимает значительную часть итерации и сдерживает скорость релизов.
- Есть стабильные функции с ясными требованиями и низкой частотой изменений.
- Команда выполняет одни и те же ручные тесты снова и снова.
- Есть ресурс на написание и поддержку автотестов: либо в команде, либо на аутсорсе.
Начинать автоматизацию лучше с уровня API и unit-тестов — они дешевле в создании и поддержке, чем UI-автотесты. UI-автоматизация (Selenium, Playwright, Cypress) — следующий шаг, когда нижние уровни покрыты.
Принцип переиспользования: хорошо написанные автотесты — это инвестиция. Page Object Model (POM) в UI-тестировании, фикстуры и хелперы в API-тестировании — паттерны, которые позволяют изменять один файл при изменении интерфейса, а не переписывать все тесты.
Типичные ошибки при организации тестирования
Тестировать только счастливый путь. Позитивные сценарии часто работают — именно их тестировали при разработке. Баги прячутся в граничных условиях, невалидных данных, неожиданных последовательностях действий.
Не тестировать требования. Непроверенные требования — источник дефектов, которые обнаруживаются на приёмочном тестировании или в продакшне. Тестировщик должен участвовать в обсуждении требований, а не только в проверке готового кода.
Игнорировать нефункциональные требования. Работает — недостаточно. Если страница загружается 15 секунд или форма уязвима к SQL-инъекции, продукт некачественный, даже если функционально он верен.
Автоматизировать нестабильные функции. Автотесты для функций, которые часто меняются, — дорогостоящий способ создать технический долг. Автоматизируйте стабильное.
Закрывать баги без верификации. Исправлено в статусе тикета — не то же самое, что исправлено в реальности. Верификация исправлений — обязательный шаг, который нередко пропускают под давлением дедлайна.
Путать severity и priority. Высокий severity не всегда означает высокий priority — и наоборот. Смешение этих понятий приводит к неправильной приоритизации работы разработчиков.
Не вести документацию. Мы всё помним работает в команде из двух человек. При росте команды или при смене сотрудников отсутствие тест-кейсов и чек-листов означает, что знания уходят вместе с людьми.
Вывод
Тестирование программного обеспечения — это не этап перед релизом, а постоянная деятельность, которая пронизывает весь жизненный цикл продукта: от анализа требований до мониторинга после деплоя.
Ключевые мысли, которые стоит забрать из этого гайда:
- Тестирование доказывает наличие дефектов, но не их отсутствие — это меняет то, как нужно интерпретировать результаты прогона.
- Исчерпывающее тестирование невозможно — поэтому тест-дизайн и приоритизация критичны.
- QA шире, чем тестирование: QC находит дефекты, QA предотвращает их.
- Автоматизация — не замена ручного тестирования, а инструмент для освобождения человеческого внимания там, где оно нужно.
- Артефакты — тест-план, тест-кейсы, баг-репорты — не бюрократия, а инструменты управления качеством и рисками.
Если вы только начинаете выстраивать процесс тестирования — не пытайтесь внедрить всё сразу. Начните с баг-трекера и smoke-теста. Это уже значительно лучше, чем ничего, и создаёт основу для роста.