Обновлено
Кратко: Нет. Полностью передать SEO нейросетям нельзя — и это не про страх перед технологиями. Это про то, что поисковики сами научились отличать машинную оптимизацию от экспертного контента, и именно экспертность теперь решает, попадёт ли страница в топ. Ниже — честный разбор: что ИИ делает лучше человека, где он проваливается, и как выстроить рабочий гибрид в 2026 году.
Оглавление
- Что изменилось в SEO к 2026 году: роль ИИ и новые правила игры
- Что нейросети умеют делать в SEO уже сейчас
- Где ИИ откровенно проигрывает живому специалисту
- Обзор ИИ-инструментов для SEO: что реально используют в 2026
- Как устроен гибридный SEO: человек + нейросеть
- Риски полной автоматизации SEO: что может пойти не так
- Искусственный интеллект как двигатель SEO-революции: смена парадигмы
- Как технически работает AI при анализе и ранжировании контента
- Как проверять ИИ-черновик перед публикацией
- Риски автоматизации, о которых говорят реже
- Как понять, что автоматизация окупается
- Часто задаваемые вопросы
- Вывод: передавать ли SEO нейросетям полностью в 2026
Что изменилось в SEO к 2026 году: роль ИИ и новые правила игры
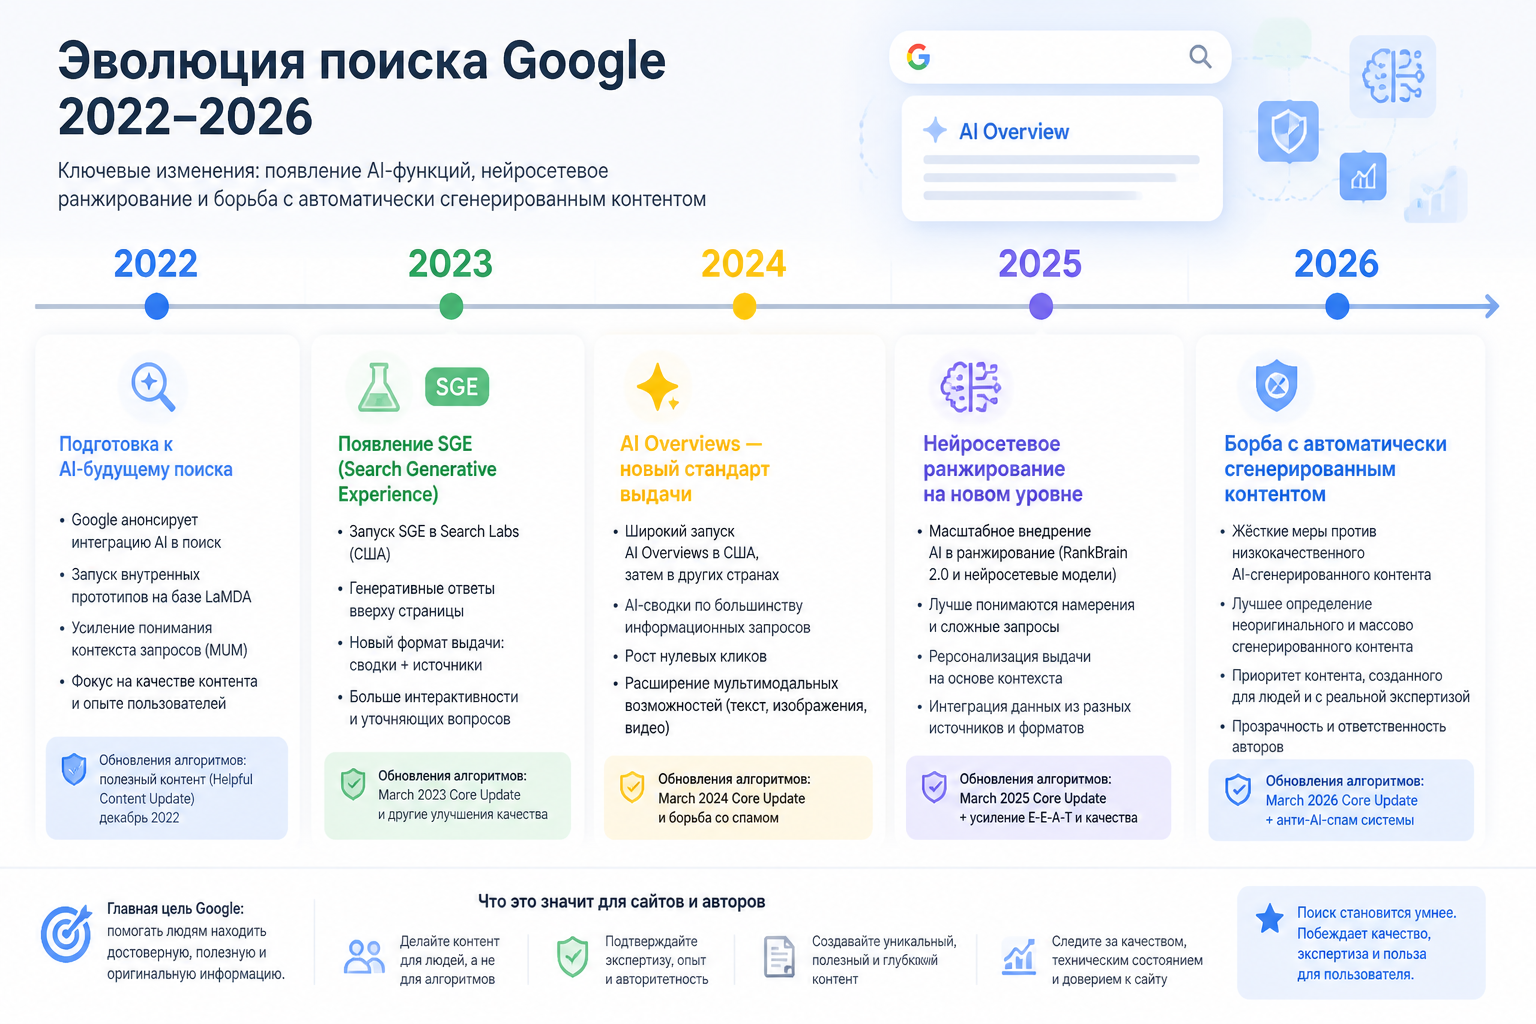
Поиск изменился структурно, а не косметически. Алгоритмы Google и Яндекса сегодня используют нейросети для понимания запросов, а не просто для сопоставления ключевых слов. Это переворачивает логику старой оптимизации.
Как поисковики сами используют нейросети
Google интегрировал AI Overviews в выдачу — сводные ответы, которые синтезируются из нескольких источников прямо на странице результатов. Это меняет поведение пользователя: часть трафика «съедается» ещё до клика на сайт. Яндекс развивает нейросетевой поиск через YandexGPT, встроенный в колдунщики.
Ранжирование теперь строится не на плотности ключей, а на понимании смысла документа, его структуры, репутации автора и связей с другими авторитетными источниками. Поисковые алгоритмы задают вопрос: «Написал ли это человек с реальным опытом?»
Почему старые SEO-методы работают хуже
Массовая закупка ссылок, статьи на 2 000 слов с набором ключей через каждый абзац, автоматические мета-теги с шаблонной подстановкой — всё это давало результат в 2018–2021 годах. Сейчас такие тактики либо нейтральны, либо вредны.
Причин несколько:
- Google Helpful Content — серия обновлений, направленных против «контента для поисковиков», а не для людей.
- Рост AI Overviews означает, что страница должна быть источником, достойным цитирования, а не просто релевантным документом.
- Яндекс последовательно снижает вес «ссылочного» в пользу поведенческих и тематических сигналов.
В этих условиях автоматизация SEO с помощью ИИ работает только там, где задача хорошо формализована. Там, где нужна интерпретация и суждение — нет.
Что нейросети умеют делать в SEO уже сейчас
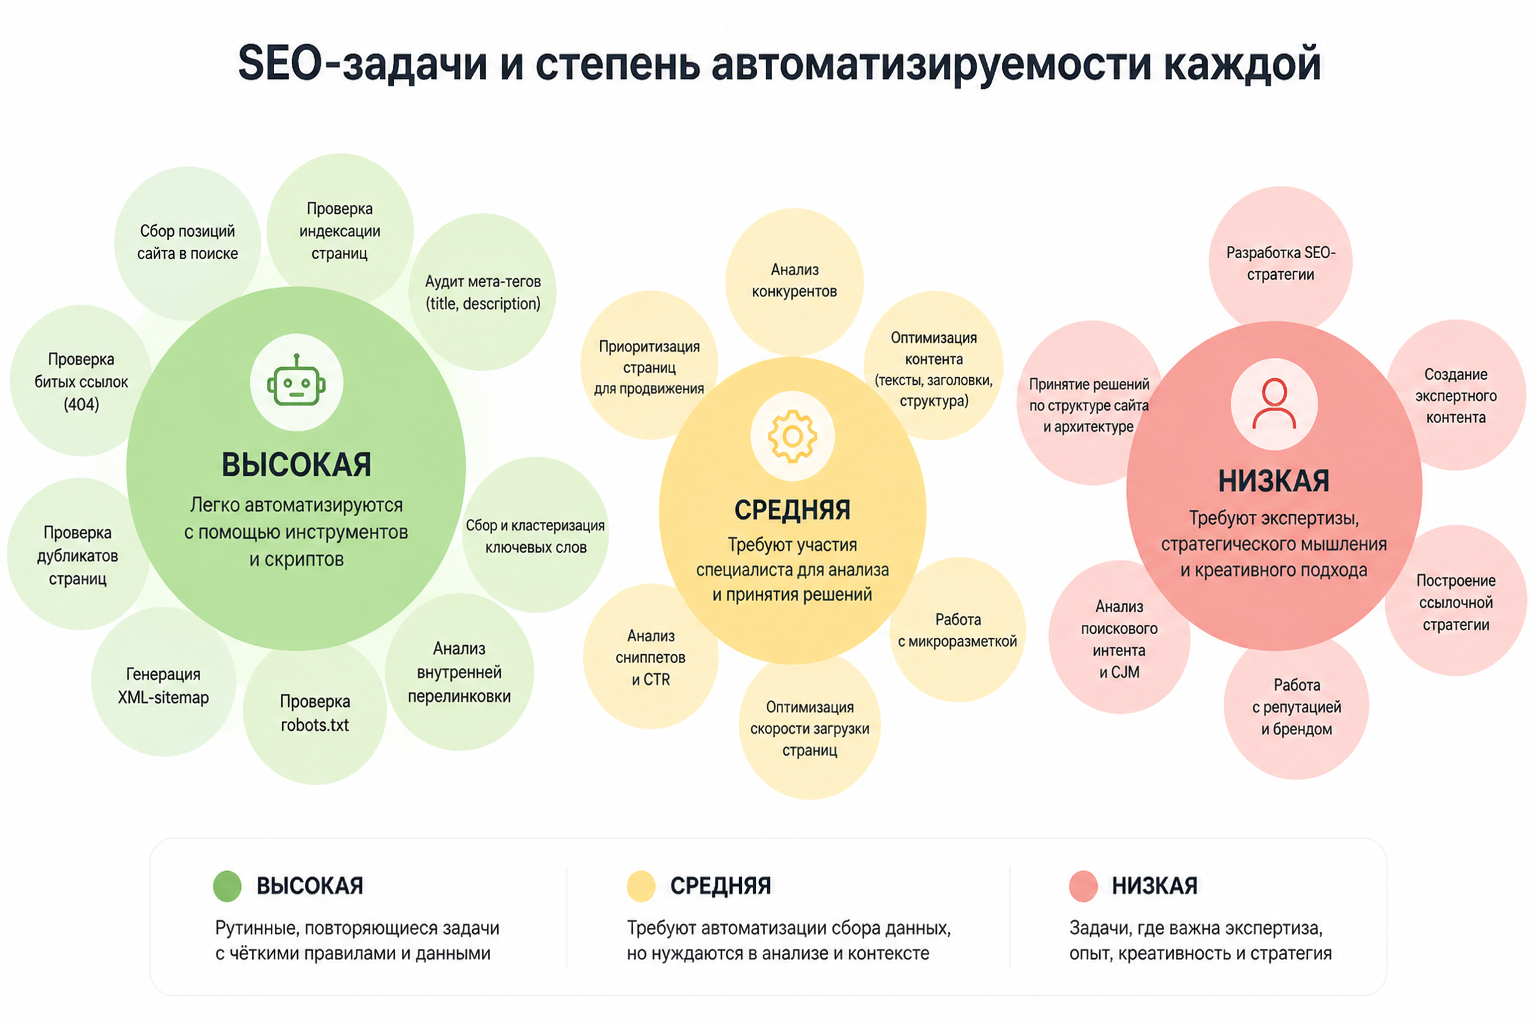
Честный ответ: многое, и с каждым кварталом — больше. Но «многое» не значит «всё» и не значит «без контроля».
Генерация и оптимизация контента
Нейросети генерируют черновики быстро. GPT-4o, Claude 3.5, Gemini 1.5 Pro — все они способны выдать структурированный текст по заданной теме, оптимизировать мета-теги, написать alt-тексты для сотен изображений, адаптировать существующий материал под другой регион или аудиторию.
Где это реально помогает:
- Быстрое создание черновиков для редактора (экономия 60–70% времени на первичный набор).
- Массовое создание карточек товаров для интернет-магазинов.
- Переработка устаревшего контента: ИИ находит устаревшие формулировки и предлагает замены.
Где нельзя пускать без надзора:
- Экспертные статьи на YMYL-темы (медицина, финансы, юридические вопросы).
- Контент, требующий реального опыта автора — обзоры, кейсы, инструкции с нюансами.
- Любые материалы, где читатель должен доверять источнику.
Сбор семантики и кластеризация запросов
Это, пожалуй, самая зрелая зона автоматизации. ИИ-инструменты (KeyAssort, Semrush AI, Ahrefs с ML-кластеризацией) группируют тысячи запросов по поисковому интенту быстрее и точнее, чем это делается вручную.
Типичный результат: за час — кластеризованная семантика на 3 000–5 000 ключей с разбивкой по типу страниц. Вручную та же работа занимала несколько рабочих дней.
Ограничение: ИИ кластеризует по формальным признакам, но не всегда понимает бизнес-логику. Пример: запросы «купить кондиционер» и «установка кондиционера» могут попасть в один кластер, хотя для сайта они требуют разных страниц с разными целевыми действиями.
Технический аудит и автоматические правки
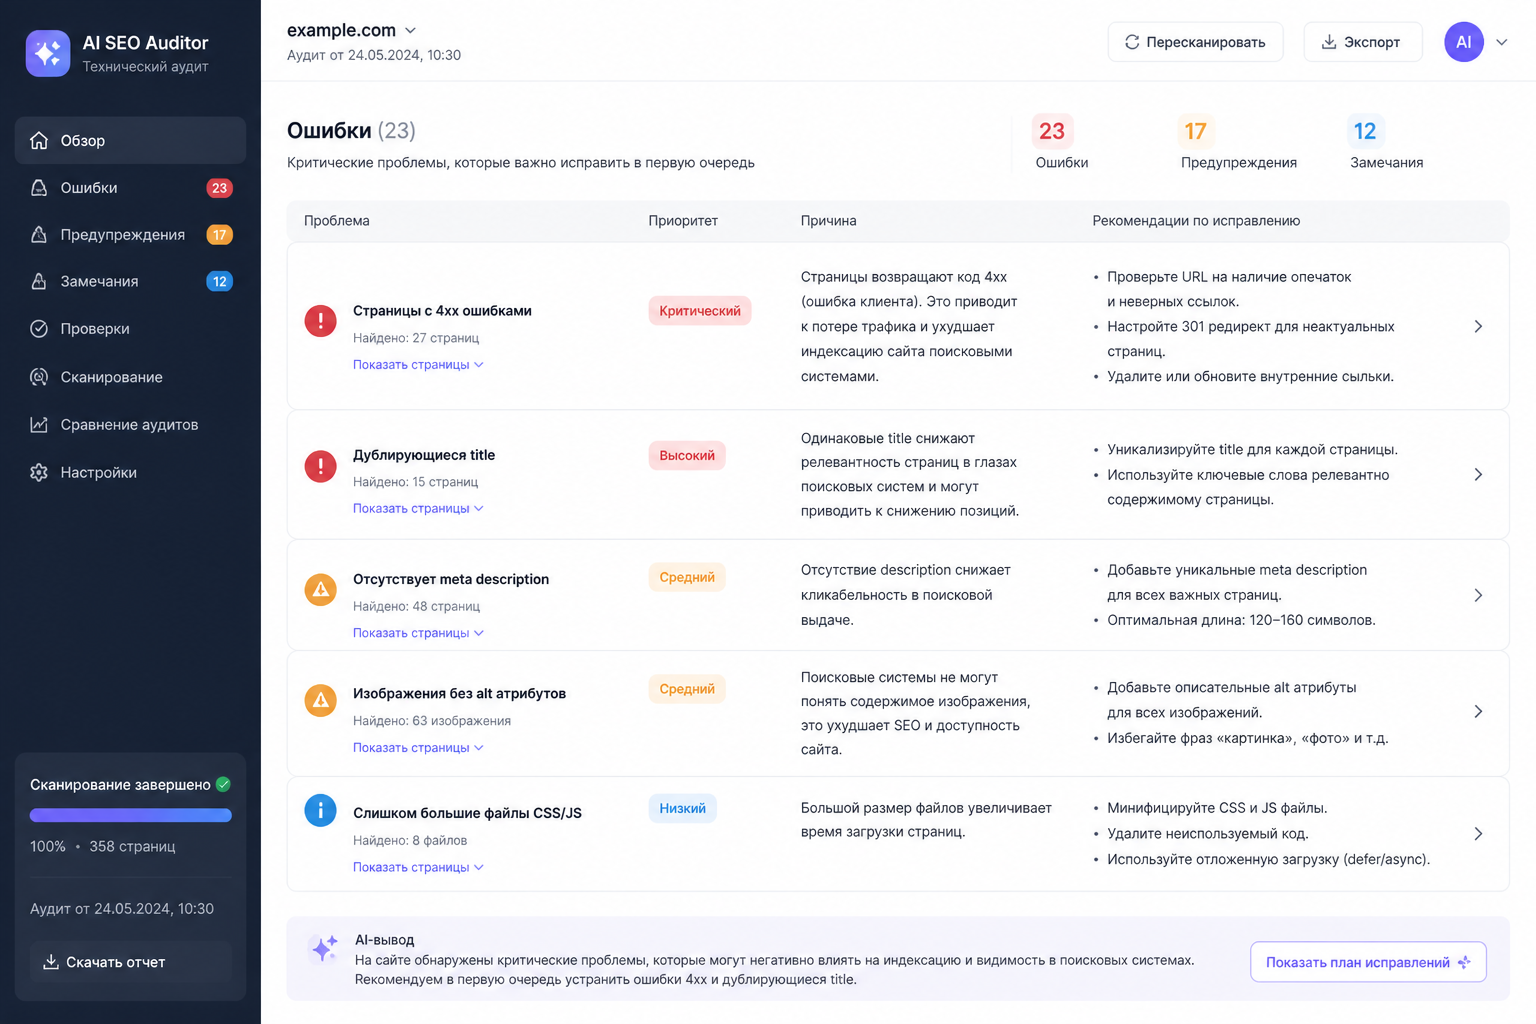
Screaming Frog с интеграцией GPT, Sitebulb, Botify — эти инструменты не просто находят ошибки, но и объясняют их влияние на ранжирование и предлагают конкретные правки.
Что хорошо автоматизируется:
- Поиск битых ссылок, дублей, редиректных цепочек.
- Анализ скорости загрузки и Core Web Vitals.
- Генерация мета-тегов по шаблону для больших сайтов.
- Выявление страниц с тонким контентом.
Что требует человека: приоритизация правок в контексте бизнеса. ИИ-аудит укажет на 200 проблем — специалист решает, какие из них критичны именно для этого сайта, а какие — технический долг, с которым можно жить.
Где ИИ откровенно проигрывает живому специалисту
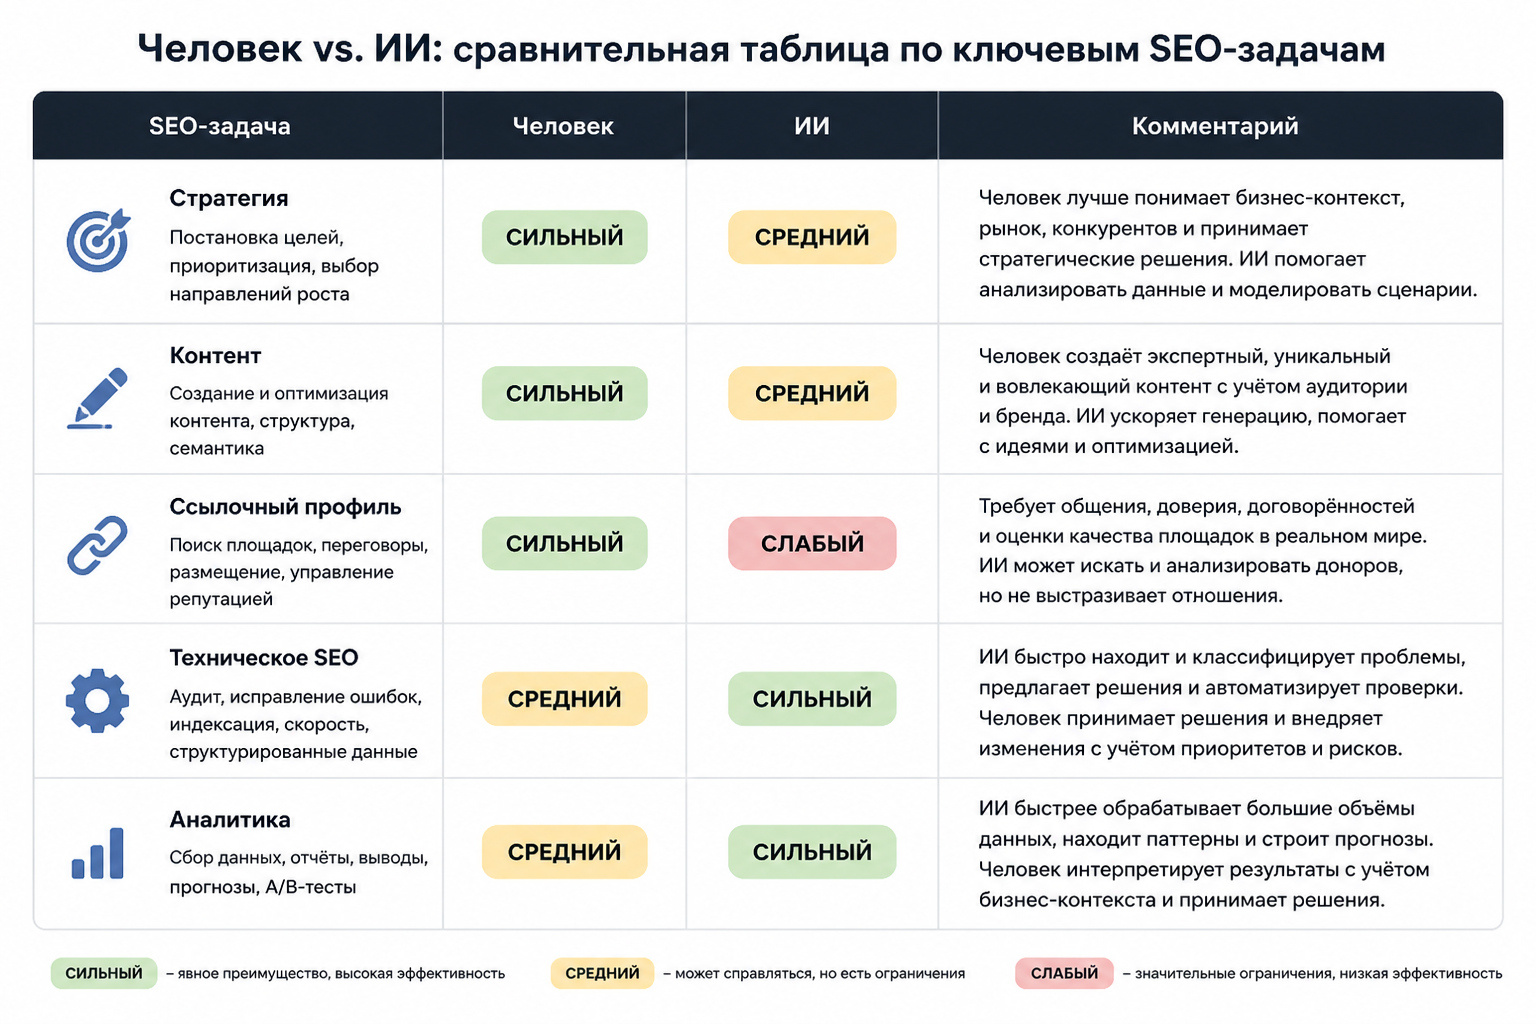
Стратегическое мышление и анализ ниши
SEO-стратегия — это решение, которое строится на понимании бизнеса, конкурентной среды, поведения аудитории и ограничений бюджета. Нейросеть может сгенерировать шаблон стратегии, но не может ответить на вопросы, которые требуют суждения:
- Стоит ли бороться за высококонкурентный запрос или уйти в длинный хвост?
- Когда сайту выгоднее купить трафик, а не растить органику?
- Как конкурент внезапно вырос — это ссылки, обновление контента или PR?
Алгоритм может ошибиться в причинно-следственных связях. Специалист — интерпретирует данные в контексте, который ИИ не видит.
Управление ссылочным профилем и репутацией
Ссылочное продвижение требует переговоров, оценки репутационных рисков, выбора доноров. Нейросеть может помочь найти потенциальные площадки или написать письмо для аутрича. Но она не:
- Оценит реальную редакционную репутацию издания.
- Распознает «ссылочную ферму» с красивым дизайном.
- Договорится о нестандартном формате размещения.
- Поймёт, что ссылка с определённого сайта токсична для конкретной ниши.
Практика клиник показывает: команды, которые полностью делегировали аутрич-кампании ИИ, периодически получали ссылки с площадок, которые впоследствии попадали под санкции. Причина — ИИ не умеет читать редакционную репутацию так, как это делает опытный линкбилдер.
E-E-A-T и экспертность: почему роботу не верят
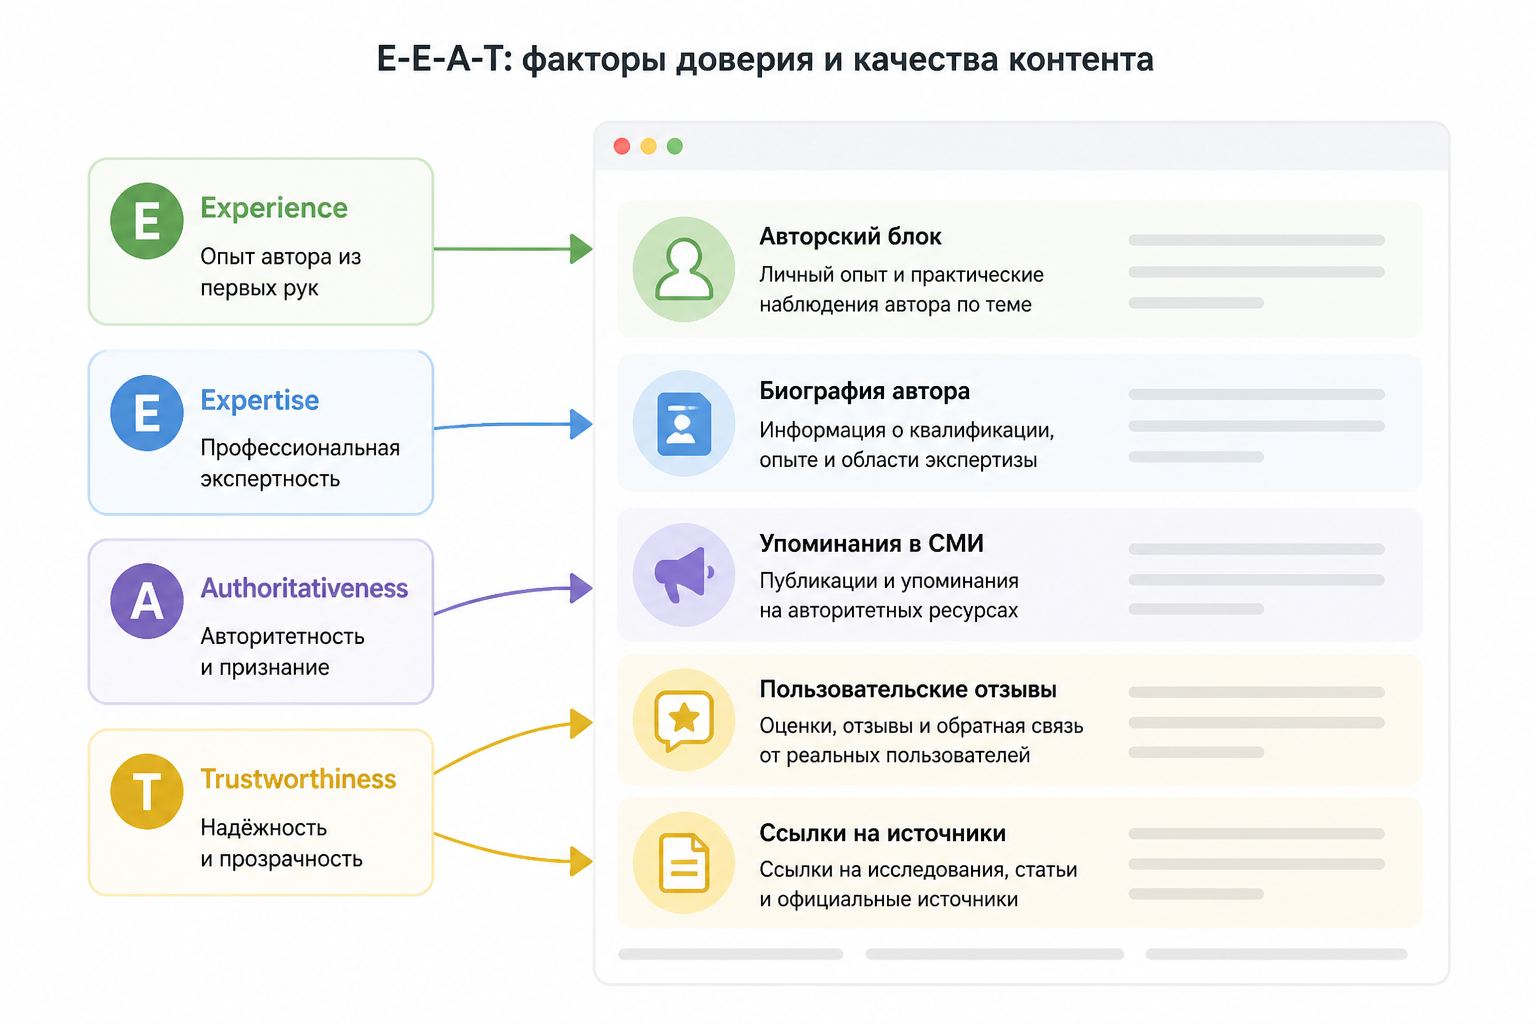
E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) — это набор сигналов, которые говорят поисковику: «Этому источнику можно доверять». Проблема в том, что реальные сигналы E-E-A-T невозможно сгенерировать:
- Experience (опыт): реальные кейсы, фотографии с места событий, конкретные истории из практики.
- Expertise (экспертиза): подтверждённые регалии автора, профессиональные публикации, упоминания в отраслевых источниках.
- Authoritativeness (авторитет): ссылки от авторитетных изданий, цитаты в СМИ, узнаваемость бренда.
- Trustworthiness (доверие): прозрачность, контакты, политика конфиденциальности, реальные отзывы.
Нейросеть может написать текст, который выглядит экспертным. Но она не может подписаться под ним как реальный специалист с репутацией. На YMYL-темах это критично: Google оценивает не только текст, но и кто за ним стоит.
Обзор ИИ-инструментов для SEO: что реально используют в 2026
Инструменты для контента (с примерами задач)
| Инструмент | Основная задача | Сильные стороны | Ограничения |
|---|---|---|---|
| Surfer SEO | Оптимизация контента под выдачу | NLP-анализ конкурентов, рекомендации по структуре | Не понимает бизнес-контекст |
| Jasper / ChatGPT (API) | Генерация черновиков | Скорость, адаптация под разные форматы | Требует редактуры, фактчекинга |
| Frase | Бриф + исследование + черновик | Удобно для небольших команд | Слабее в русскоязычной семантике |
| MarketMuse | Контентная стратегия и аудит | Глубокий анализ тематических пробелов | Дорогой, ориентирован на английский |
Для русскоязычного SEO в 2026 году наиболее востребована связка: Яндекс GPT / Claude для черновиков + ручная редактура специалиста с экспертизой в нише.
Инструменты для технического SEO
- Screaming Frog + GPT-плагин — краулинг с автоматическими объяснениями ошибок и рекомендациями.
- Sitebulb — визуализация структуры сайта, приоритизация проблем по влиянию.
- Botify — корпоративный уровень; ML-анализ краулингового бюджета.
- IndexNow — автоматическая переиндексация страниц при обновлении (интегрируется с CMS).
Важная оговорка: инструменты находят проблемы. Приоритеты расставляет человек.
Платформы комплексной автоматизации
В 2026 году появились «SEO-оркестраторы» — системы, которые пытаются объединить семантику, контент, технический аудит и отчётность в одном интерфейсе. Примеры: SE Ranking с AI-модулями, Semrush Copilot, ряд локальных решений для Рунета.
Честная оценка: пока они лучше всего справляются с рутинным мониторингом и уведомлениями. Полноценного «автопилота» для SEO ни одна из платформ не обеспечивает — на горизонте 2026 года это маркетинговое позиционирование, а не реальная функциональность.
Как устроен гибридный SEO: человек + нейросеть
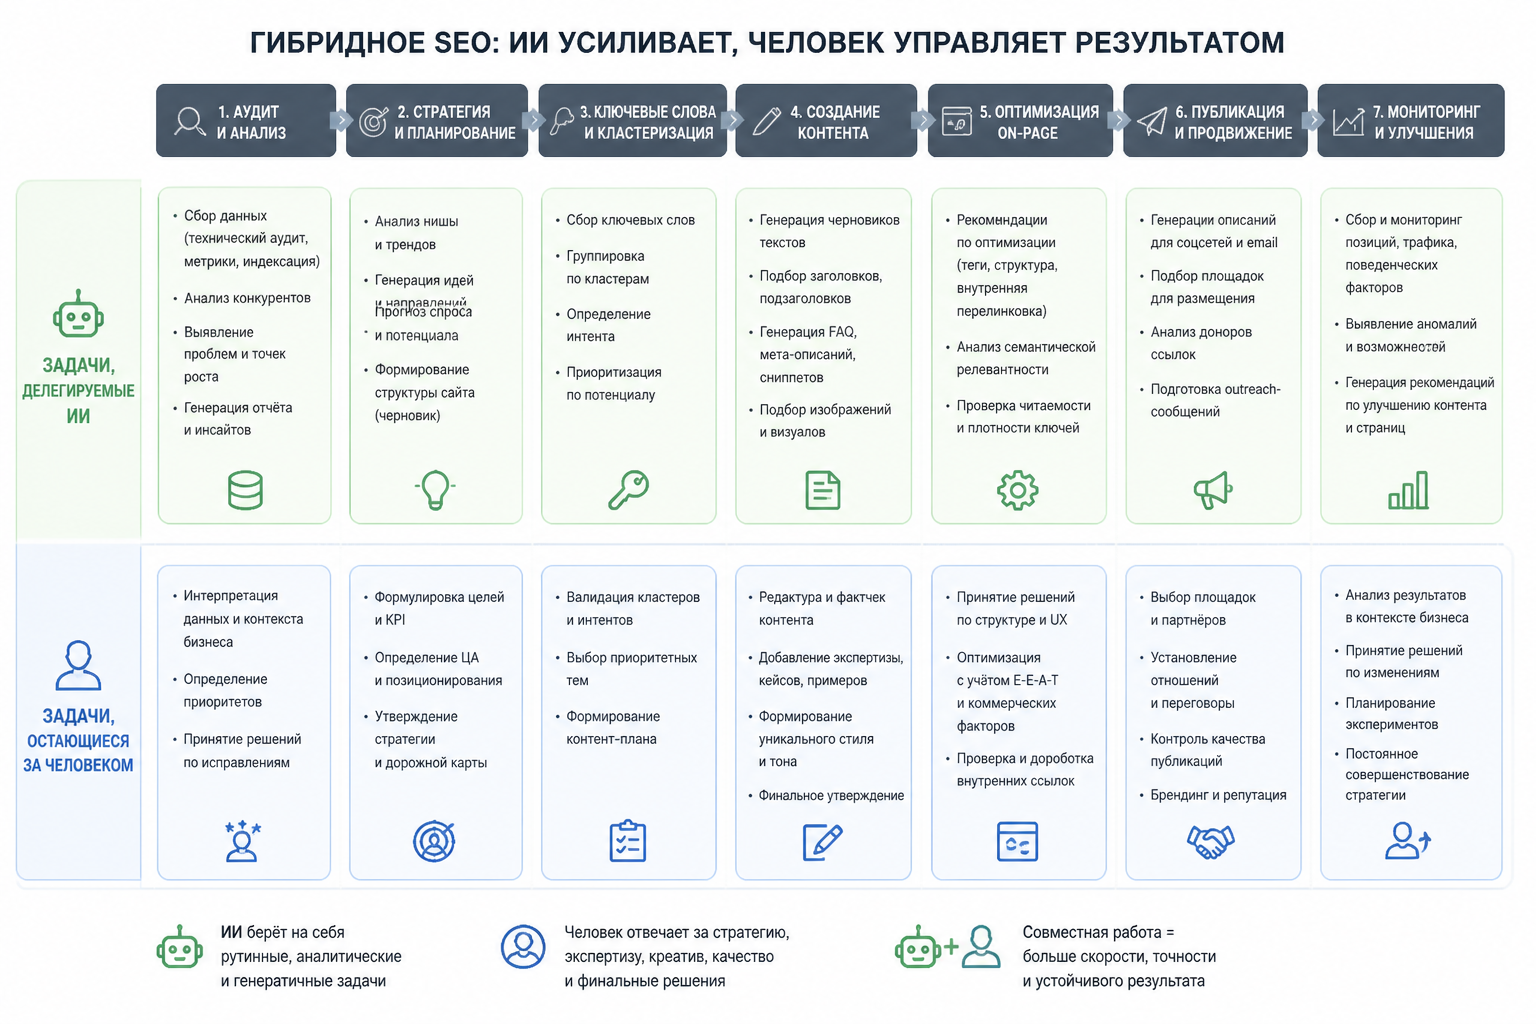
Какие задачи делегируем ИИ, какие оставляем людям
| Задача | Кто делает | Почему |
|---|---|---|
| Сбор и кластеризация семантики | ИИ | Формализованная задача, масштаб |
| Технический аудит (сканирование) | ИИ | Скорость, полнота охвата |
| Приоритизация технических правок | Человек | Нужен бизнес-контекст |
| Генерация мета-тегов (типовые страницы) | ИИ | Масштабируемо, шаблонизировано |
| Написание экспертного контента | Человек (ИИ — черновик) | E-E-A-T, доверие, факты |
| Аутрич и переговоры о ссылках | Человек | Репутация, отношения |
| Мониторинг позиций и трафика | ИИ | Автоматизировано, регулярно |
| Интерпретация аномалий и причин | Человек | Суждение, контекст |
| SEO-стратегия | Человек (ИИ — данные) | Не формализуется |
| Создание авторских профилей, E-E-A-T | Человек | Невозможно сгенерировать |
Примерный рабочий стек для небольшой команды
Ситуация: команда из двух человек (SEO-специалист + контент-редактор), сайт с 500–2 000 страницами.
Еженедельный цикл:
- Мониторинг — Semrush / SE Ranking автоматически собирает позиции, флагирует просадки. Специалист тратит 30–40 минут на просмотр дашборда.
- Технический аудит — раз в две недели Screaming Frog или Sitebulb сканирует сайт. ИИ-модуль генерирует список проблем. Специалист выбирает критичные.
- Контент-производство — редактор получает ТЗ (кластер + интент + структура), использует Claude или GPT для черновика, дорабатывает вручную, добавляет экспертные детали и реальные примеры.
- Семантика — раз в квартал ИИ-кластеризация новых запросов, специалист проверяет логику и корректирует под бизнес-задачи.
- Ссылки — аутрич ведёт специалист, ИИ помогает с поиском площадок и письмами.
Такой стек позволяет команде из двух человек закрывать объём работ, который раньше требовал 4–5 исполнителей. Это реальная экономия — не за счёт качества, а за счёт устранения рутины.
Риски полной автоматизации SEO: что может пойти не так
Санкции за автоматически сгенерированный контент
Google Helpful Content Update и последующие итерации алгоритма научились идентифицировать паттерны машинного текста — не по «детектору ИИ», а по сигналам качества: низкая вовлечённость, отсутствие оригинального опыта, формульная структура.
Сайты, которые в 2023–2024 годах массово заливали AI-контент без редактуры, в значительной части потеряли органический трафик после серии обновлений. Яндекс, по публичным заявлениям, также работает над фильтрацией «контента ради контента».
Важная оговорка: сам по себе ИИ-контент не запрещён ни Google, ни Яндексом. Запрещён контент, созданный с единственной целью манипуляции поиском, который не несёт ценности пользователю. Разница — в качестве и намерении, а не в инструменте.
Практический риск: если весь контент генерирует ИИ без редактуры, вы не контролируете точность фактов, тональность, соответствие реальному опыту компании. Ошибка в медицинской или юридической статье, опубликованная автоматически, — это не только SEO-риск, но и репутационный.
Ошибки в семантике и потеря позиций
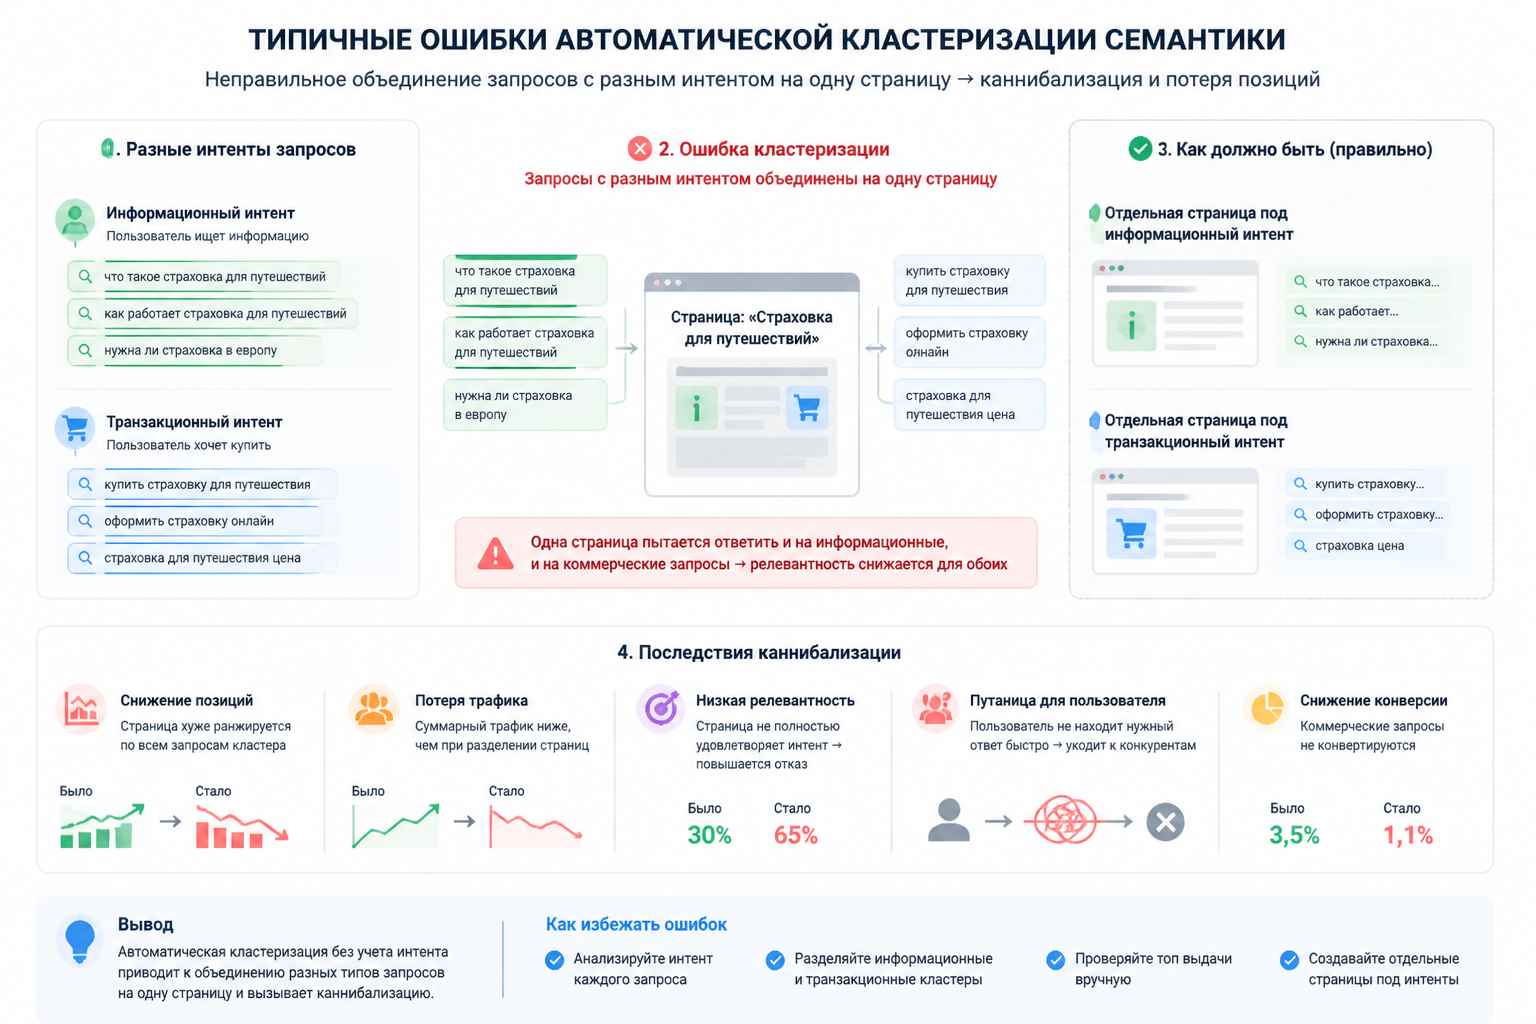
Автоматическая кластеризация иногда объединяет запросы с разным интентом на одну страницу. Это приводит к каннибализации: страница пытается отвечать на два разных вопроса и не отвечает хорошо ни на один.
Типичные ошибки:
- Коммерческие и информационные запросы в одном кластере → страница продажи пытается объяснять, страница-статья пытается продавать.
- Региональные вариации смешиваются → одна страница «оптимизирована» под Москву и Санкт-Петербург одновременно.
- Синонимы с разными интентами попадают вместе → «лечение спины» (информационный) и «клиника лечения спины» (коммерческий) на одной странице.
Дополнительный риск: автоматическое создание контента в масштабе иногда порождает дубли. Сотни похожих страниц с минимальными различиями — классический сигнал low-quality для поисковиков.
Итог: автоматизацию семантики нужно сочетать с ручной проверкой логики перед тем, как запускать производство контента.
Искусственный интеллект как двигатель SEO-революции: смена парадигмы
SEO прошло три эпохи, и границы между ними — не косметика, а смена самого объекта оптимизации.
Первая эпоха (условно до 2015 года) — оптимизация под ключевые слова: точное вхождение фразы в тег title, плотность ключей в тексте, количество внешних ссылок. Вторая эпоха — оптимизация под пользовательские сигналы: поведенческие факторы, скорость загрузки, мобильная адаптация, структурированные данные. Третья эпоха, в которой мы находимся сейчас, — оптимизация под смысл и намерение. Это не эволюция прежних методов, а замена самого предмета работы: раньше специалист оптимизировал документ под запрос, теперь — под задачу пользователя, которую поисковая система пытается понять целиком, включая контекст, историю поиска и формулировку вопроса своими словами, а не набором ключей.
Это и есть суть «SEO-революции», о которой чаще говорят маркетингово, чем по существу. Революция не в том, что появился новый инструмент генерации текста. Революция в том, что искусственный интеллект изменил саму механику поиска — а значит, изменил и то, что считается «оптимизированной» страницей. Раньше оптимизация была работой с формой: заголовками, тегами, структурой URL. Сейчас она стала работой с содержанием в буквальном смысле — насколько полно, точно и без противоречий документ отвечает на вопрос, который пользователь мог даже не сформулировать явно.
Практическое следствие для специалистов: инструменты автоматизации, описанные выше, эффективны ровно настолько, насколько они помогают работать со смыслом, а не с формой. Автоматический подбор ключевых слов или шаблонная генерация мета-тегов — это оптимизация старой эпохи, которую ИИ выполняет быстро, но которая сама по себе больше не двигает страницу в топ. Настоящий эффект даёт другое: использование ИИ для проверки полноты раскрытия темы — находит ли алгоритм пробелы в сравнении с тем, что уже отвечает на похожие вопросы в выдаче, — и для проверки логической связности документа. Это смещение фокуса с «как написать» на «что и насколько полно раскрыть» — и есть содержательная часть революции, а не факт появления генеративных моделей как таковых.
Как технически работает AI при анализе и ранжировании контента
Чтобы понять, почему шаблонная оптимизация перестала работать, полезно понимать — хотя бы на уровне принципа — как современные системы обрабатывают текст.
Ключевой механизм — векторные представления (embeddings). Вместо того чтобы сравнивать слова как строки символов, языковые модели переводят фрагменты текста в числовые векторы, отражающие смысл. Два предложения с разными словами, но одинаковым значением — «где отремонтировать телефон» и «сервис по ремонту смартфонов» — оказываются близко друг к другу в этом векторном пространстве. Это и есть техническая причина, по которой набор синонимов в тексте больше не нужно перечислять вручную: система распознаёт смысловую близость сама, а искусственная плотность ключевых слов ничего не добавляет и может даже восприниматься как сигнал низкого качества.
Второй элемент — распознавание сущностей (entities) и построение семантических графов. Поисковая система связывает упоминания в тексте с объектами реального мира: людьми, организациями, местами, понятиями — и сверяет их с уже существующей базой знаний. Если статья про клинику упоминает конкретный метод лечения, алгоритм проверяет, насколько это упоминание согласуется с тем, что известно о данном методе из других авторитетных источников. Отсюда и растущее значение фактической точности: противоречие с общепринятыми сведениями в теме — не стилистическая ошибка, а сигнал недостоверности.
Третий элемент — механизм, лежащий в основе AI Overviews и подобных функций в Яндексе: генерация ответа на основе извлечения (retrieval-augmented generation, RAG). Система сначала находит релевантные фрагменты из проиндексированных страниц, затем языковая модель формирует из них связный ответ, часто со ссылкой на источник. Практическое следствие для оптимизации: чтобы фрагмент страницы попал в такую выборку, он должен быть самодостаточным — отвечать на конкретный подвопрос ясно и в пределах одного-двух абзацев, без необходимости читать весь материал целиком для понимания контекста. Это меняет требования к структуре текста: чёткие подзаголовки, прямые ответы сразу после вопроса, отсутствие «размазанных» по всей странице объяснений одной мысли.
Понимание этой механики объясняет, почему инструменты вроде Surfer SEO или MarketMuse полезны не потому, что подбирают ключевые слова, а потому, что показывают, какие смысловые узлы — сущности, подтемы, связанные вопросы — уже присутствуют у конкурентов в выдаче и отсутствуют в вашем материале. Это работа с семантическим графом темы, а не с частотностью фраз, и именно в этом заключается практическая польза ИИ-инструментов для специалиста, который хочет не обмануть алгоритм, а действительно закрыть тему полнее конкурентов.
Как проверять ИИ-черновик перед публикацией
Редакторская проверка ИИ-черновика — это обязательный этап между генерацией текста и публикацией. На нём человек проверяет факты, отделяет общие слова от полезных ответов и добавляет то, чего у модели нет: реальный опыт, данные компании и выводы по сути. Без этого этапа автоматизация контента превращается в выпуск непроверенных текстов.
Удобнее проверять черновик в несколько проходов, у каждого своя задача. Если пытаться поймать всё за одно чтение, внимание рассеивается, и в первую очередь пропускаются фактические ошибки.
| Проход | Что проверяем | Типичная проблема ИИ-черновика |
|---|---|---|
| Факты | Цифры, даты, названия, ссылки на исследования | Модель уверенно приводит несуществующие данные или устаревшие версии продуктов |
| Интент | Отвечает ли текст на тот вопрос, ради которого пришёл пользователь | Ответ теряется среди общих рассуждений о теме |
| Опыт | Есть ли примеры и детали, которых нет у конкурентов | Текст пересказывает то же, что уже есть в выдаче |
| Структура | Самодостаточны ли разделы, есть ли прямой ответ в начале | Одна мысль размазана по нескольким абзацам |
| Тон и бренд | Совпадают ли формулировки с позицией компании | Обещания и оценки, которые компания не готова подтвердить |
Самый рискованный проход — фактический. Языковая модель не отличает проверенное знание от правдоподобной выдумки, поэтому любую цифру, на которую ссылается текст, нужно либо подтвердить первоисточником, либо удалить. Есть и правило попроще: если редактор не может за пару минут найти, откуда взялась цифра, её не публикуют.
Риски автоматизации, о которых говорят реже
Помимо санкций и ошибок в семантике, у автоматизации SEO есть риски, которые не видны в отчёте о позициях. Это утечка данных через внешние сервисы, зависимость от одного поставщика инструментов и постепенная потеря компетенции внутри команды. Каждый из них может обойтись дороже, чем просадка трафика.
Конфиденциальность. Чтобы получить точный ответ, в ИИ-сервис часто загружают выгрузки из аналитики, данные о заказах, внутренние документы и семантику, собранную за годы. До загрузки стоит выяснить, как сервис хранит и использует эти данные, и решить, что вообще можно передавать за пределы компании. Особенно это касается персональных данных клиентов.
Зависимость от инструмента. Когда процесс целиком построен вокруг одной платформы, любое её изменение бьёт по всей работе: новые тарифы, закрытый API, ограничения доступа из региона, другая логика кластеризации. Лучше держать данные в своих таблицах и хранилищах, а инструмент использовать как обработчик, который можно заменить.
Потеря экспертизы. Если команда годами только принимает решения, предложенные ИИ-инструментом, она перестаёт понимать, почему эти решения работают. Когда ранжирование резко меняется или появляется нестандартная задача, разобраться оказывается некому. Поэтому даже автоматизированные участки стоит периодически разбирать вручную: смотреть, на каких данных инструмент сделал вывод и согласен ли с ним специалист.
Как понять, что автоматизация окупается
Автоматизация окупается, если сэкономленное время уходит в задачи, которые двигают сайт: стратегию, экспертный контент, работу с репутацией. Если при этом не падает качество на выходе, это тоже должно быть видно. Скорость сама по себе не показатель: быстрее выпущенные слабые страницы дают отрицательный эффект.
Для оценки удобно сравнивать состояние до и после внедрения по нескольким параметрам, а не по одной метрике:
- Время на задачу. Сколько уходит на один и тот же объём работы (кластеризацию, аудит, подготовку черновика) вручную и с ИИ, включая время на проверку результата.
- Доля правок. Какую часть ИИ-результата приходится переделывать. Если редактор переписывает черновик почти целиком, экономии нет.
- Качество страниц. Как ведут себя опубликованные материалы: видимость в поиске, поведение пользователей, попадание фрагментов в ответы нейросетей.
- Ошибки. Сколько фактических и логических ошибок дошло до публикации и сколько поймали на проверке.
Оценивать имеет смысл через несколько циклов работы, а не сразу. На первых итерациях время часто уходит на настройку промптов, шаблонов и правил проверки. Если же доля правок со временем не снижается, задача, скорее всего, плохо формализуется, и её лучше вернуть человеку.
Часто задаваемые вопросы
Вывод: передавать ли SEO нейросетям полностью в 2026
Нет. И вот конкретно почему — без общих слов.
Поисковые алгоритмы в 2026 году сами построены на нейросетях и целенаправленно обучены находить контент с реальной экспертностью. Попытка обмануть нейросеть другой нейросетью — это гонка, в которой у поисковика всегда больше данных и больше вычислительных мощностей.
Что стоит автоматизировать прямо сейчас:
- Технический мониторинг и аудит.
- Сбор и первичную кластеризацию семантики.
- Генерацию черновиков для типовых страниц (с обязательной редактурой).
- Отчётность и мониторинг позиций.
- Мета-теги для больших каталогов по шаблону.
Что оставить людям:
- Стратегию продвижения и приоритизацию задач.
- Экспертный контент на YMYL-темы.
- Управление ссылочным профилем.
- Формирование E-E-A-T: авторские профили, репутация, реальный опыт.
- Интерпретацию аналитических данных и принятие решений.
Гибридная модель — не компромисс, а оптимум для 2026 года. ИИ убирает рутину, высвобождая время специалиста для задач, где человеческое суждение незаменимо. Команда из двух человек с правильным стеком закрывает работу, которую раньше делали пятеро — но только при условии, что люди контролируют качество на выходе.
Практическая рекомендация: начните с аудита того, что в вашем SEO-процессе сейчас делается вручную и занимает больше всего времени при минимальном творческом вкладе. Туда идёт ИИ в первую очередь. Всё, что требует суждения, репутации или реального опыта — остаётся за человеком. Эта граница не изменится в ближайшие один-два года, даже если инструменты станут лучше.
Если вы выстраиваете SEO-процесс с нуля или хотите пересмотреть текущую модель — разберём вашу ситуацию конкретно: какие задачи отдать ИИ, как организовать контроль качества и что реально даст результат для вашего сайта.